インシデント管理は、ITサービスで発生する障害を対処するための大事なプロセスです。
本書はインシデント管理の目的と活動内容を分かりやすく解説します。
ITIL、基本情報技術者試験を受験される方や、ITサービス業務を担当される方は参考にしてください。
インシデントとは
ITサービスにおいて、サービスが正常に使えない状態をインシデントと呼びます。
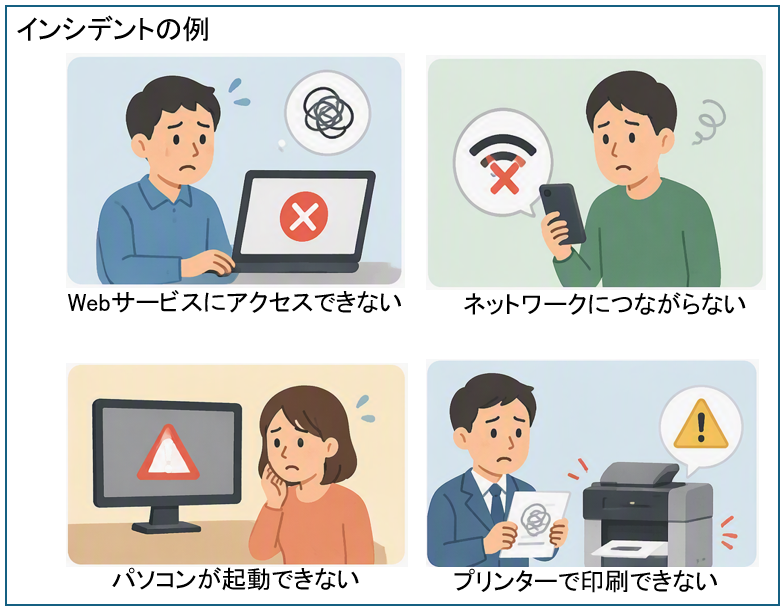
インシデントの例
インシデントは利用者が「困った」と感じる出来事全般です。
- Webサービスにアクセスできない
- ネットワークにつながらない
- パソコンが起動できない
- プリンターで印刷できない
インシデントの定義
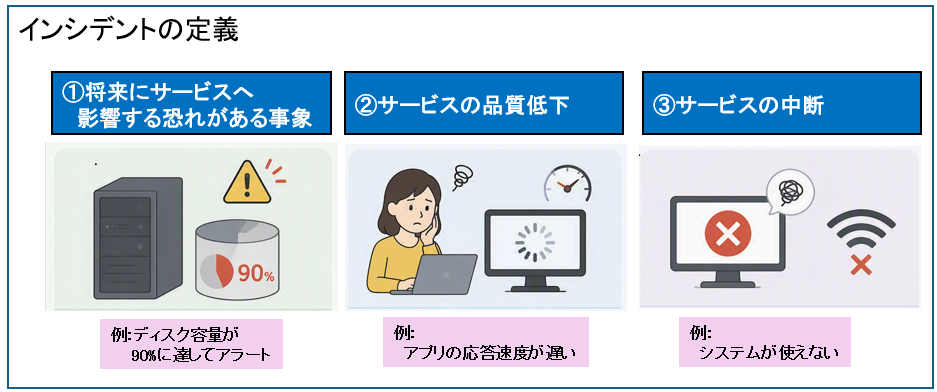
ITILでは「インシデントとは、ITサービスの正常な運用を妨げる、または妨げる恐れのある予期しないイベントのこと」と定義しています。
インシデントは必ずしも障害(故障)が原因とは限らず、ユーザにとってサービス利用に支障が出る、またはその恐れがある状態を指し、次の3つがインシデントに該当します。
- サービスの中断や品質低下につながる可能性がある事象
(例:ディスク容量が90%に達しているアラート) - サービス品質低下
(例:アプリが非常に遅くなった、一部機能が利用できない) - サービスの中断
(例:サーバーダウンでシステムが使えない)
インシデントと障害や問題管理との違い
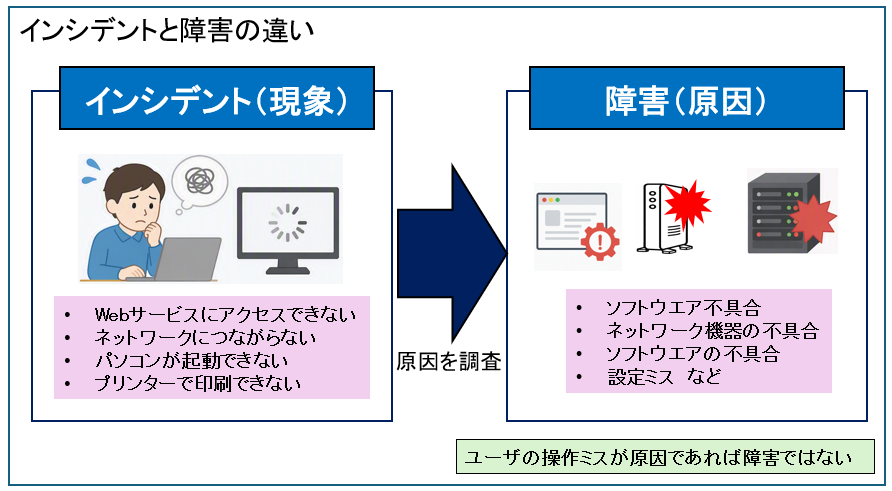
インシデントは「現象」障害は「原因」と考えると分かりやすいです。
例えば、「ログインできない」、「システムが遅い」は インシデントです。
そして、原因調査後「サーバ障害だった」、「ネットワーク故障だった」は障害(原因)です。
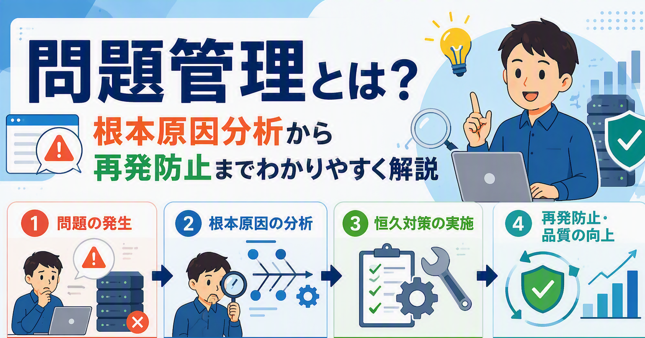
原因究明や再発防止は、問題管理プロセスで行います。
インシデント管理の目的
ITILではインシデント管理の目的は「インシデントが発生した際に、可能な限り迅速に通常のサービス運用を回復させ、ビジネスへの影響を最小限に抑えること」とあります。
次の2つがポイントです。
- 迅速な復旧
- ビジネスへの影響最小化
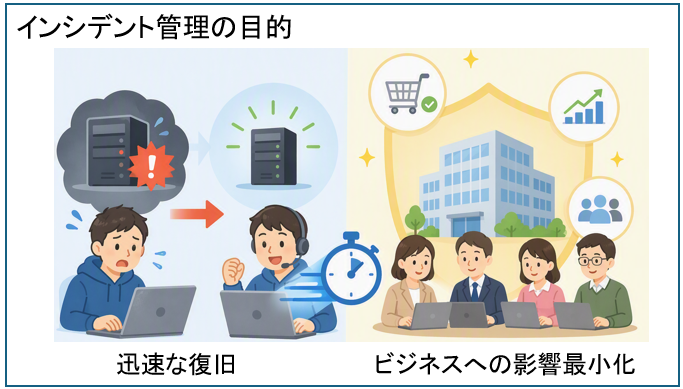
とにかく早く回復するのが目的(応急処置でもOK)
原因究明や再発防止は、問題管理プロセスで行います。
インシデント管理の具体的な内容
インシデント管理の活動内容は次の通りです。

- 記録と分類
- 優先付け
- 初期サポート
- 調査と診断
- 解決と復旧
①記録と分類
■インシデントの種類
| インシデントの種類の例 | 説明 |
|---|---|
| サーバ停止 | サーバーダウン、システムが全く動作しないなど |
| アプリケーション障害 | 画面が表示されない、機能が使えないなど |
| パフォーマンス低下 | レスポンスが遅いなど |
| セキュリティ関連 | ウイルス感染、不正アクセス、情報漏洩の疑いなど ※セキュリティ関連については、必要に応じて情報セキュリティ管理プロセスと連携 |
■影響度(どこに影響が出ているか)
| 影響範囲の例 | 説明 |
|---|---|
| 高:全ユーザ | 全体的な障害 |
| 中:特定部門・グループ | 部署やチーム単位で発生 |
| 中:特定機能利用者 | ○○業務担当者 |
| 低:影響なし | 例えば次のような場合です。 ・サーバのストレージ障害だが冗長構成のため影響なし ・現在使用されていない機能のみに影響 |
■緊急性
例えば次のように高(緊急対応)、中(早急対応)、低(通常対応)などで設定をします。
- 高(例:全社員の業務が停止、本日期限の決算処理)
- 中(例:代替手段はあるが非効率)
- 低(例:レポートを出力したいがすぐ必要ではない)
②優先付け
優先度は基本的に影響度と緊急性をもとに設定をします。
下の図のように、優先度マトリックスを用意しておきます。

優先度は予めの定義をしておき、SLAにも記載をします。
次は優先度の例になります。
- 優先度:高・・・他のインシデント対応よりも優先して対応
- 優先度:中・・・後回し可能だが、優先度:低よりも優先して対応
- 優先度:低・・・優先度:高、中が完了したら対応
③初期サポート
運用マニュアルや、過去のインシデント記録を参照して既知の内容かどうかを確認します。
サービスデスクで解決できない内容であれば、専門部隊へエスカレーションします。

④調査と診断
調査と診断では、原因を確認し、恒久対策に向けた準備をします。
調査と診断で実施する内容としては次のような例があります。
- ログファイル、システムの状態、構成情報(最近実施したリリースや設定変更など)などを確認
- 同じ条件でインシデントが再現できるか試す
⑤解決と復旧
解決と復旧は、通常の業務状態に戻すためのフェーズです。
ここでは、根本解決に時間がかかる場合は、暫定処置(応急処置)を実施します。
ワークアラウンド
暫定処置(応急処置)のことをワークアラウンドと言います。
■ワークアラウンドの例
| 状況 | ワークアラウンド |
|---|---|
| ブラウザがEdgeだとフォームの送信が動作しない。 | Firefoxを使って送信するように指示。 |
| ログイン後にフリーズする。 | 一度ログアウトしてから再ログインすると正常に動作するため、毎回その操作を行うようアナウンスする。 |
インシデント管理では、恒久対策よりも早期復旧を優先します。
ワークアラウンドは恒久対策ではなく、一時的に影響を回避・軽減する手段です。恒久対策は、問題管理プロセスで対応されます。
解決と復旧の活動
解決と復旧での活動は次の通りです。
- ソフトウェアの修正、設定変更、再起動、リソース増強など
修正後に問題が再発していないか、ユーザー操作に支障がないか動作確認 - ユーザへ対応完了の報告(必要があれば注意点なども共有)
インシデントの原因調査や復旧手順は、インシデント管理(専用のツール、DB、Excelなど)に残し、再発した場合に備えるようにします。
また、残すべき手順は運用マニュアルに残すことで他メンバーへの共有、別の担当者へ引継ぎなどが楽になります。

インシデント・モデル
インシデント・モデルは、頻発する可能性のあるインシデントに対して迅速かつ適切に対応できるように、事前に手順をまとめておいたものです。
<インシデント・モデルの例>
■インシデントの分類:認証/認可の問題(ログイン失敗)
■影響範囲:特定のユーザーまたは全ユーザー
■優先度:高(ユーザーがシステムにアクセスできないため)
■対応手順:
①ログイン画面でのエラーメッセージを確認
②サーバーログや認証サーバーのログを確認
③上の①、②の情報を開発部門へ送付して調査依頼
インシデント管理のKPI
インシデント管理のKPIは次のような項目があります。
平均復旧時間(MTTR:Mean Time To Restore)
平均復旧時間(MTTR)は、インシデント発生からサービス復旧までに要した時間の平均値です。
MTTRが短いほど、サービスを迅速に復旧できていることを意味します。そのため、多くの組織で最も重要なKPIの一つとして利用されています。
<例>
・障害A:30分で復旧
・障害B:60分で復旧
・障害C:90分で復旧
⇒MTTR = (30 + 60 + 90)÷ 3 = 60分
インシデント件数
一定期間内に発生したインシデントの件数です。
件数の推移を監視することで、システムやサービスの安定性を把握できます。件数が急激に増加している場合は、システム障害や運用品質の低下が発生している可能性があります。
- 日別の発生件数
- 月別の発生件数
- サービス別の発生件数
- 重大インシデント件数
SLA達成率
SLA(Service Level Agreement)達成率は、定められた目標時間内にインシデントを解決できた割合を示します。
<例>
・総インシデント数:100件
・目標時間内に解決:95件
⇒SLA達成率 = 95 ÷ 100 × 100 = 95%
一次解決率
一次解決率は、サービスデスクが最初の問い合わせ対応で問題を解決できた割合です。
一次解決率が高いほど、利用者は迅速にサポートを受けられ、エスカレーションや対応コストの削減にもつながります。
利用者満足度
インシデント管理は単に障害を解決するだけでなく、利用者が満足できるサービスを提供することも重要です。
アンケートやフィードバックを活用して満足度を測定し、サービス品質の改善に役立てます。
重大インシデント発生件数
事業への影響が大きい重大インシデントの発生件数を管理します。
インシデント総数が少なくても、重大インシデントが発生するとビジネスへの影響は非常に大きくなります。そのため、一般的なインシデント件数とは別に監視することが推奨されます。
FAQ・よくある質問
まとめ
- インシデントは「ITサービスの正常な運用を妨げる予期しないイベント」であり、障害に限らず、パフォーマンス低下や予兆的な事象も含まれます。
- インシデント管理の目的は、迅速なサービス復旧とビジネスへの影響の最小化であり、恒久対策よりも回復のスピードを優先します。
- インシデントの分類・優先付けには、「影響度」と「緊急性」の観点が重要であり、優先度マトリクスを活用して一貫した判断を行います。
- ワークアラウンド(応急処置)は、恒久対策ではないが、早期復旧のために有効な手段として活用されます。
- セキュリティ関連のインシデントは、必要に応じて情報セキュリティ管理プロセスと連携し、適切な対応体制を整えます。
腕試し(理解テスト)
腕試し(理解テスト)に挑戦する場合はこちらをクリック。
コメント