問題管理とは、発生したインシデントの根本原因を特定し、再発防止を実現するためのITILの管理プロセスです。
インシデント管理が「迅速な復旧」を目的とするのに対し、問題管理は「再発防止」を目的としています。
この記事では以下を解説します。
- 問題管理とは
- インシデント管理との違い
- 問題管理の流れ
- 根本原因分析の手法
- 具体例
- KPI
問題管理とは
問題管理の目的
問題管理の目的は、インシデントや障害の根本原因を特定し、再発防止策や未然防止策を提案することです。
- インシデントの根本原因を技術的に分析し特定
- 恒久的な解決策の提供(根本解決)
一時的な回避策(ワークアラウンド)ではなく、再発しないように根本的な対応を行います。 - インシデントの再発防止
同様の障害が再び発生しないように、システムや運用の改善を行います。
問題管理の具体例
Webサーバが頻繁に停止する
- 事象
サーバーを再起動すると復旧するが、毎月同じ障害が発生している。 - 問題管理での扱い
根本原因を調査し、メモリリークが原因であることを特定する。
データベース性能劣化
- 事象
毎週月曜日にレスポンスが遅くなる - 問題管理での扱い
ログ分析の結果、大量バッチ処理との競合が原因だった。
問題管理とインシデント管理の違い
問題管理とインシデント管理の違いを表にまとめました。
| 項目 | 問題管理 | インシデント管理 |
|---|---|---|
| 目的 | 再発防止 | 迅速復旧 |
| 対象 | 問題(Problem) | インシデント |
| 重視点 | 原因分析 | サービス復旧 |
| 対応期間 | 中長期 | 短期 |
| 成果物 | 恒久対策 | 復旧結果 |
問題管理のプロセスや活動内容
問題管理はインシデント発生後に実施するリアクティブの対応と、インシデントが発生する前に実施するプロアクティブの対応があります。
リアクティブな問題管理
リアクティブな問題管理は、既に発生したインシデントの根本原因を調査し、教訓を得て再発防止策を提案して対応します。
■活動の流れ
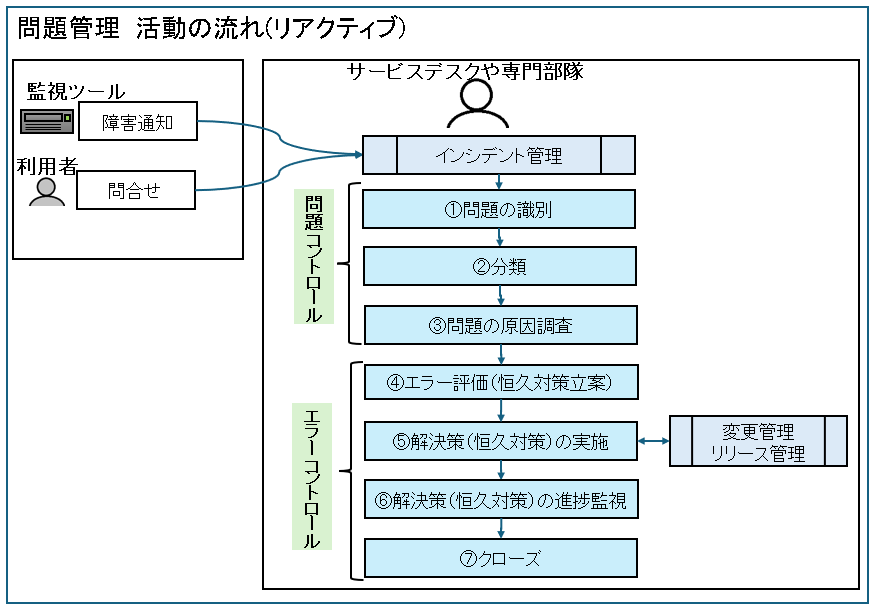
インシデント(障害)が発生した後にその根本原因を特定するプロセスを問題コントロールと言い、フローだと①~③が該当します。
問題の修正、予防、変更管理との連携はエラーコントロールと言います。
①問題の識別
インシデント管理から対象のインシデントを確認します。
インシデント管理から問題管理に移転する条件の例
- 同一インシデントが◯回以上発生
- 重大障害(影響度:高)
②分類
分類の項目に決まりはないですが、問題の種類や重要度、影響範囲に基づいて分類を行い、優先度を決定します。
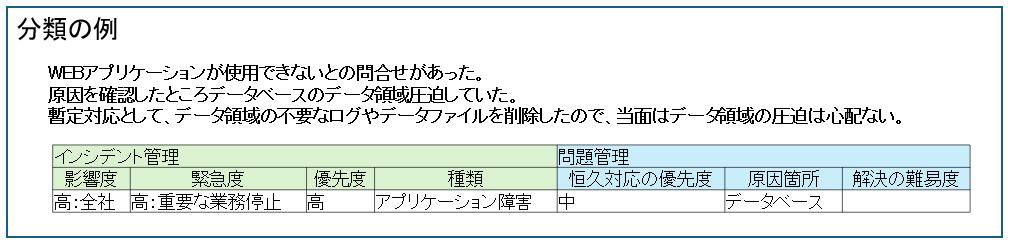
分類のフェーズで設定できない項目は次の原因調査で埋めても良いです。
③原因調査
問題の根本的な原因を特定します。
具体的な活動内容は次の通りです。
- ログを確認
- 監視ツールの確認(障害発生時のCPU、メモリ、ストレージ領域の使用率や、サービスの稼働状況など)
- プログラムのソースコードを確認
- パッケージソフトの場合はサポートへ問合せ
インシデント管理で得られた情報を基に問題管理の調査が行われることが多いですが、根本原因を特定するためには追加の調査が必要な場合もあります。
システム的な原因を確認できたら、なぜそれが起きたのかを分析します。
この分析手法としては、なぜなぜ分析や、フィッシュボーンダイアグラム(特性要因図)がよく使用されます
■なぜなぜ分析の例
問題:WEBアプリケーションは使用できなかった
1 なぜ → アプリケーションがデータベースに接続できなくなり、データの読み書きができなかった
2 なぜ → データベースのデータ領域の空きが無くなり、WEBアプリが動かなくなった
3(1)なぜ → 容量監視ができていなかった
4(1)なぜ → 監視体制が不十分
5(1)なぜ → 運用手順が不明確で、監視ツールのアラート設定がされていなかった。
3(2)予想以上にデータ領域が増加
4(2)なぜ → 先週にリリースした自動登録バッチ機能によりデータが増加していた
5(2)なぜ → 自動登録バッチ機能追加に伴うデータ増加を考慮できていなかった
④エラー評価(恒久対策立案)
エラー評価(恒久対策立案)では、問題を根本的に解決するための恒久対策(長期的な対策)を考えます。
例えば次のような例があります。
- ソフトウェアの修正やパッチ適用
- インフラのアップグレードや交換
- プロセスの改善(手順の再設計、トレーニングの実施)
- 監視体制の強化
先ほどのWEBアプリケーションの問題の例の場合は次のような対策が考えられます。
・データベース容量の定期的な監視とアラート設定。
・自動的なデータ圧縮やアーカイブ機能の導入。
・運用ポリシーの整備と、容量管理担当者の明確化。
提案された恒久対策がどの程度効果的で、どのようなリスクがあるかを評価します。
新しい対策が他の問題を引き起こさないか、実施後の影響を予測することが重要です。
⑤解決策(恒久対策)の実施
解決策(恒久対策)の実施 は、問題の根本原因を解決するために立案した恒久的な対策を実際に実行します。
先ほど説明した「④エラー評価(恒久対策立案)」を実施します。
恒久対策がソフトウェアの修正や、ハードウェアの交換、運用プロセスの変更を含む場合、それらの実施は変更管理プロセスに従って行われます。
問題管理は、これらの対策が実行されることを確認する役割を担います。
ただし、次のような例は変更管理の対象外です。
■変更管理対象外
- オペレーター改善に向けたトレーニングの実施
- 管轄外(構成管理対象外)の運用マニュアル修正
⑥解決策(恒久対策)の進捗監視
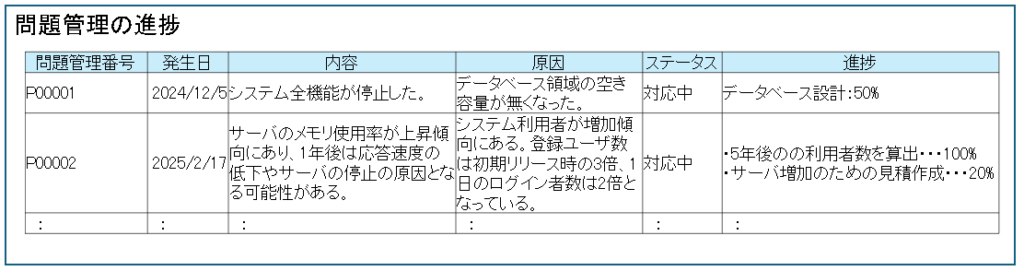
対策が計画通り進んでいるか、スケジュール通りに作業が実施されているかを報告します。
問題が複数存在する場合は、問題管理の記録データベース(またはExcel)や、課題管理表を使って定期的印報告をします。
ソフトウエアの修正などの変更管理で実施する活動は、変更管理で進捗を管理しますが、問題管理側でも進捗を管理する場合は問題管理で上がっている問題のリストを作成して報告すると良いです。
プロアクティブな問題管理
プロアクティブな問題管理はインシデントが発生する前に未然に防ぐことです。

- 潜在的な問題の特定
将来インシデントになりそうな兆候やリスクを洗い出します。
例:監視ツールによるCPUなどの使用率増加傾向、ユーザーからの小さな不満・問い合わせ - リスク分析
特定した潜在問題について、どれくらい危険かを評価します。
具体的には、発生可能性、影響度や影響範囲などから評価します。 - 予防策の計画と実施
リスクを低減・排除するための対策を考え、実行します。 - 効果の評価と改善
実施した予防策が本当に効果があったかを確認し、必要なら改善します。
Known Error(既知エラー)とは
根本原因が特定され、一時的な回避策(ワークアラウンド)や恒久的な対策も判明しているものの、まだ完全な解決には至っていない状態の問題のことです。
恒久対策はない場合でも、Known Errorとワークアラウンドを登録しておくことで、同じ障害が発生した場合でも迅速な復旧が可能になります。
報告書のサンプル
問題管理で対応する問題は、顧客へ報告が必要ですが、報告書に記載すべき内容のサンプルを記載します。
(企業によってはテンプレートが決まっていると思いますので、その場合はテンプレートを使ってください。)
(■と□の箇所は選択肢を表しており、■が本サンプルの該当項目です。)
| 問題発生日 | xxxx年xx月xx日 |
| 影響度 | ■高 □中 □低 |
| 緊急度 | 高:最優先で対応 |
| 内容 | WEBシステムにアクセスするとエラーメッセージが表示されて利用できない。 ○○業務、□□業務を行う全ユーザが業務できない状態となった。 確認したところ、データベース領域の使用率が100%となっていた。 |
| 発生フェーズ | □リリース前 ■リリース後(瑕疵担保期間内) □リリース後(瑕疵担保期間外) |
| 暫定復旧内容 | データベース領域に過去のリリース作業前に出力したデータベースバックアップ(ダンプファイル)が残っていたので、開発担当者に確認して削除した。 |
| 関連システムへの影響 | 本システムと連携しているXXシステムへのデータ送信が停止した。 |
| 障害発生原因の工程箇所 | □要件定義 ■プログラム設計(基本設計や詳細設計) □プログラミング □リリース作業 ■運用設計 |
| インシデント発生~回復 (ワークアラウンド)に至るまでの経緯 | 8:00 x様からシステムへログインできないとの問合せがあった 8:00 運用保守担当のy氏からシステム全利用者と関連システム担当者へ障害が発生している旨をアナウンスした。 8:15 運用保守担当のy氏がアプリケーションサーバを再起動したが解消しなかった。 8:30 監視ツールでシステムの状況を確認したところ、データベース領域の使用率が100%となっていた。 9:00 データベース領域に過去のリリース作業前に出力したデータベースバックアップ(ダンプファイル)が残っていたので、開発担当者に確認して削除した。 9:15 システムの動作確認をして、システム全利用者へ障害が回復した旨をアナウンスした。 |
| 問題発生の経緯 | データベースへ登録するデータおよびログ領域の使用量が増えた。 |
| 原因 | 1 なぜ → アプリケーションがデータベースに接続できなくなり、データの読み書きができなかった 2 なぜ → データベースのデータ領域の空きが無くなり、WEBアプリが動かなくなった 3(1)なぜ → 容量監視ができていなかった 4(1)なぜ → 監視体制が不十分 5(1)なぜ → 運用手順が不明確で、監視ツールのアラート設定がされていなかった。 3(2)予想以上にデータ領域が増加 4(2)なぜ → 先週にリリースした自動登録バッチ機能によりデータが増加していた 5(2)なぜ → 自動登録バッチ機能追加に伴うデータ増加を考慮できていなかった |
| 恒久対応 | ・データベース容量の定期的な監視とアラート設定。 ・自動的なデータ圧縮やアーカイブ機能の導入。 ・運用ポリシーの整備と、容量管理担当者の明確化。 |
問題管理のKPI
問題管理におけるKPIは次の項目があります。
問題解決件数
一定期間内に解決した問題(Problem)の件数です。
問題解決件数を把握することで、組織がどれだけ問題管理活動を実施できているかを確認できます。
根本原因特定率
登録された問題のうち、根本原因を特定できた割合です。
問題管理の重要な目的の一つが根本原因の特定であるため、この指標は活動の有効性を評価する上で重要です。
<計算式>
根本原因を特定できた問題数 ÷ 登録された問題数 × 100
平均解決期間
問題の登録からクローズまでに要した期間の平均値です。
長期間未解決の問題が増加すると、将来的なインシデント発生リスクが高まるため、継続的な監視が必要です。
再発率
恒久対策を実施した後に、同じ原因によるインシデントが再発した割合です。
再発率が低いほど、問題管理が効果的に機能していることを示します。
Known Error件数
Known Errorとして登録されている問題件数です。
Known Errorが長期間放置されている場合は、恒久対策が進んでいない可能性があるため、定期的な確認が必要です。
重大問題件数
事業やサービスに大きな影響を与える重大な問題の件数です。
重大問題の発生傾向を分析することで、優先的に改善すべき領域を特定できます。
まとめ
- 問題管理はインシデントの根本原因を特定し、再発防止策を講じるプロセス。
- インシデントの再発を防ぐために、システムや運用の改善を行う。
- 問題管理にはリアクティブ(事後対応)とプロアクティブ(事前対応)の2つのアプローチがある。
- リアクティブな問題管理では、インシデント後に根本原因を特定し、再発防止策を提案する。
- 問題識別、分類、原因調査、エラー評価(恒久対策立案)が主なステップ。
- 「なぜなぜ分析」や「フィッシュボーンダイアグラム」を使い、根本原因を特定する。
- 恒久対策の例として、ソフトウェア修正、インフラのアップグレード、監視体制の強化がある。
- 解決策(恒久対策)の実施は、変更管理プロセスに基づいて行われる。
- 進捗監視を通じて、恒久対策が計画通りに実施されているかを確認する。
- 問題管理報告書では、インシデントの詳細、原因、対応策、恒久対策が含まれる。
腕試し(理解テスト)
腕試し(理解テスト)に挑戦する場合はこちらをクリック。
コメント