LLMのモデルとは何かを初心者向けに解説。モデルとプログラムの違い、パラメータの意味、学習の仕組み、大規模モデルと小規模モデルの特徴を図解でわかりやすく紹介します。
LLMとは何か
モデルの説明をする前にLLMを知っておく必要があります。
LLMとは
LLMは、Large Language Modelの略で、大規模言語モデルと呼ばれます。
LLMは、大量の文章データを学習することで、入力された文章に対して以下のことができます。
- 文脈に合った文章を生成
- 質問に回答
- 文章を要約
- 翻訳
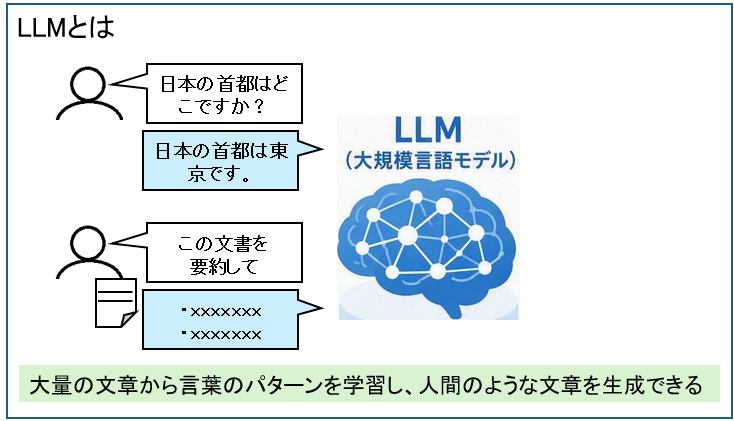
LLMは学習結果として非常に多くのパラメータが決まります。
この「パラメータ」については後ほど説明します。
モデルとは?
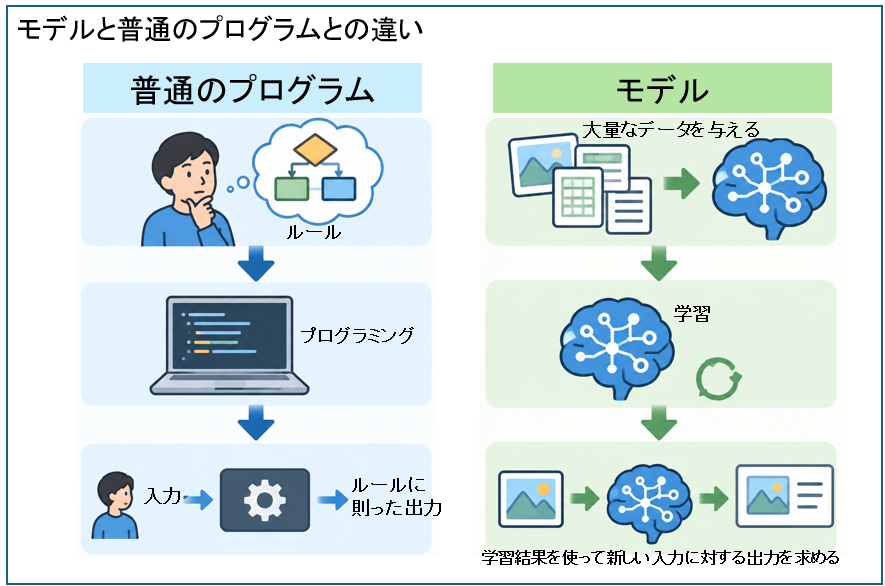
AIにおけるモデルについて、普通のプログラムと比較しながら考えてみましょう。
モデルと普通のプログラムとの違い
プログラマーがルールを考えて、そのルールをプログラムとして記述しています。
一方、機械学習は大量のデータを与え、そこからコンピューターにパターンを学習させます。
学習によって決まる「パラメータ」とは
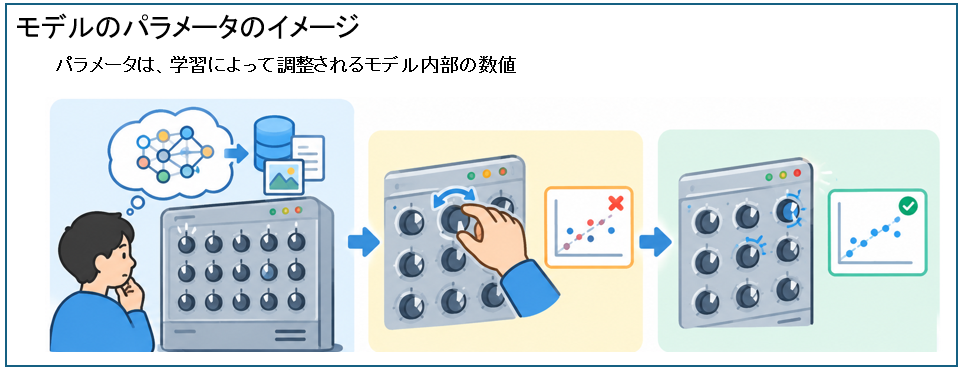
パラメータとは、「学習によって調整されるモデル内部の数値」と考えてください。
イメージとしては、非常にたくさんの調整つまみがある機械を想像すると分かりやすいでしょう。
(実際には数学的な計算によって数値を調整します。)
最初は、それぞれのつまみが適切な状態になっていません。
そこでデータを使いながら、「こちらを少し動かす」、 「間違いが減った」、 「今度はこちらを調整する」ということを大量に繰り返していきます。
モデルとパラメータの関係をざっくり理解する
ここでも機械に例えてみます。
ある機械の中に、大量の調整つまみが付いているとします。
機械全体の仕組みがモデルだとすると、その中にある調整可能な値がパラメータです。
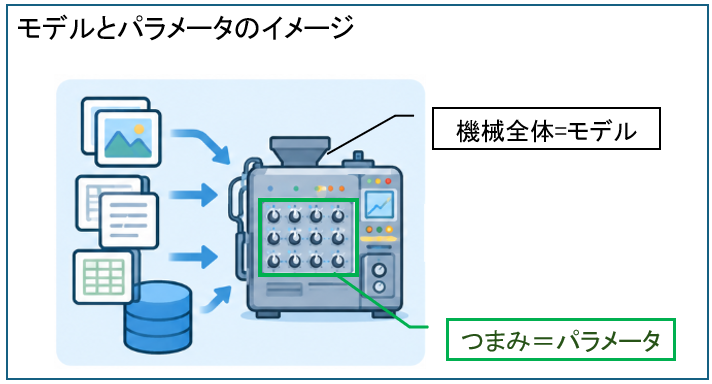
学習ではデータを使って、そのパラメータを調整していきます。
厳密には「モデル」という言葉が、次の両方の意味で使われることがあります。
①モデルの構造・アーキテクチャ ・・・ ニューラルネットワークの構成や計算方法
②学習済みモデル ・・・ 構造に学習済みパラメータが組み合わさったもの
モデルはどうやって作られる?
LLMは、大量のテキストデータを使って、文章中の単語やトークンの並び方などのパターンを学習します。
代表的な事前学習では、文章の続きを予測するようなタスクを通じて、パラメータを調整していきます。
その結果、学習したパターンをもとに、入力された文章に続く内容を生成できるようになります。
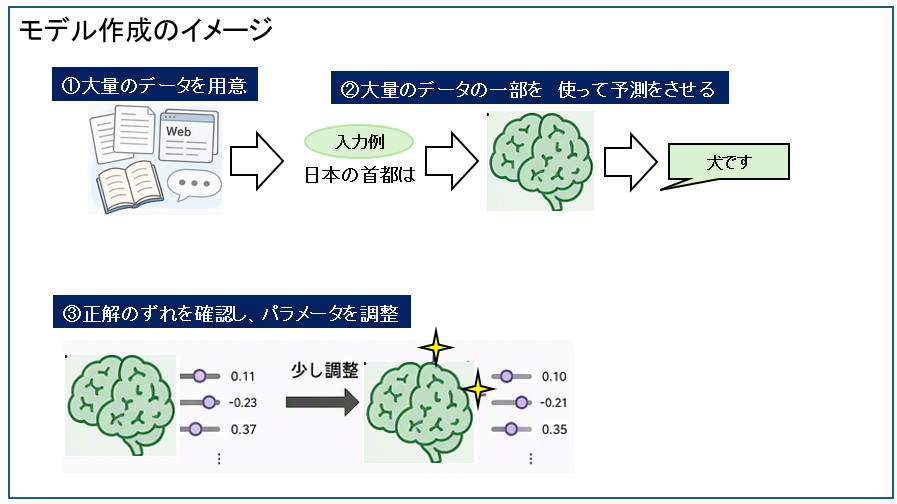
まず大量のデータを用意する
LLMを学習させるには、学習に使用するデータが必要です。
文章を扱えるモデルを作りたいのであれば、モデルにさまざまな文章のパターンを学習させる必要があります。
ここで重要なのは、単に文章をモデルの中へ保存しているわけではなく、大量の文章から、言葉と言葉の関係や文章のパターンを学んでいます。
「学習」とは何をしているのか
学習では、データを使いながらパラメータの数値を調整していきます。
先ほどのイメージの例で「日本の首都は」に対し「犬です」と予測したら、実際の文章からどのくらいズレていたのかを計算します。
学習が終わったものが「学習済みモデル」
こうして学習を行い、調整されたパラメータを持っているモデルを、学習済みモデルと呼びます。
私たちがLLMを利用するときは、この学習済みモデルに文章などを入力します。
モデルの規模とは
LLMについて調べていると、次にような表現を目にすることがあります。
- 大規模なモデル
- 小さなモデル
- ○○Bパラメータのモデル
LLMではモデルの規模を説明するときに、パラメータ数が一つの指標としてよく使われます。
「○Bパラメータ」のBって何?
モデル規模を「4B」や「70B」などと表記を見ることがありますが、この BはBillion(10億) を表します。
例えば「7Bパラメータ」であれば、名前の上では約70億個のパラメータを持つモデルという意味になります。
ここで注意したいのは、パラメータを「知識の件数」と考えないことです。
パラメータ数で何が変わるの?
パラメータ数が多くなれば、モデル内部で調整できる数値も多くなります。
先ほどの機械を例にすると、『モデルが学習によって調整できる「つまみ」が増える』ということです。
大規模モデル(パラメータ数が多い)メリットとデメリット
大規模モデル(パラメータ数が多い)メリットとデメリットは次の通りです。
メリット
具体的には次メリットがあります。
- 言葉と言葉の関係
- 文章の構造
- 文脈による違い
- さまざまな表現のパターン
注意したいのは、「パラメータが多ければ多いほど優秀か」について、必ずしもそうではないということです。
デメリット
- モデルの訓練や運用、維持には非常に高価なGPUや大容量メモリが必要となり、膨大なコストが必要
小規模モデル(パラメータ数が少ない)メリットとデメリット
モデル規模が小さいこと(軽量モデルであること)場合、次のメリットやデメリットがあります。
メリット
- レスポンスが早い
- スペックが低いマシンで動かせる
デメリット
- 複雑な論理思考や高度な推論、長文の文脈理解において大型モデルに劣る
- 不確実な情報であっても自信をもって回答してしまう
モデル規模ごとの特徴と用途
| モデル規模 | 特徴 | 主な用途 |
|---|---|---|
| 小規模モデル (1B〜7B程度) | ・比較的軽量で、必要なメモリや計算資源を抑えやすい。 ・ローカルPCなどで動作させやすいモデルもある。 ・特定の用途に絞ることで、効率的に利用できる。 | ・簡単な文章の要約 ・定型的な質問への回答 ・特定業務に特化したチャットボット |
| 中規模モデル (7B〜30B程度) | ・性能と計算コストのバランスを取りやすい。 ・一般的な文章生成やコード生成など | ・プログラムコードの生成・補助 ・文書の要約や翻訳 ・社内FAQシステム ・業務効率化ツールへの組み込み |
| 大規模モデル (30B〜70B程度) | ・一般的に、大きな計算資源や運用コストが必要になりやすい | ・複雑な質問への回答 ・高度な文章生成・編集 ・専門文書の分析 ・複雑なタスクを実行するAIエージェント |
| 超大規模モデル (100B以上) | ・複雑なタスクや高度な言語処理を目的としたモデル | ・高度な推論や複雑な問題解決 ・専門性の高い文章生成 ・大規模な業務支援システム |
学習と推論の違い
LLMには、大きく分けて「学習」と「推論」という処理があります。
- 学習は、大量のデータを使ってモデルのパラメータを調整する処理です。
- 推論は、学習済みのモデルに文章などを入力し、その結果を計算して出力する処理です。
まとめ
- LLM(大規模言語モデル)は、大量のテキストデータを学習し、文章の理解や生成を行うAIモデル
- パラメータは、モデルがデータのパターンを学習する際に調整される数値
- LLMは、学習データの内容を単純なデータベースのように保存して検索しているわけではなく、文章中の単語やトークンの並び方などのパターンを学習する
- 大規模モデルと小規模モデルにはそれぞれ特徴があり、パラメータ数だけでなく、用途や計算資源、コストなどを考慮して選択することが重要
コメント