ローカルLLMのLM Studio Bionicのインストール方法、モデルのダウンロード手順、初期設定などの使い方と、日本語対応可否、商用利用の可否、動作が遅い場合の対処法まで初心者向けに紹介します。
【広告】
本ページにはアフィリエイト広告が含まれています。
ローカルLLMとは
ローカルLLMとは、自分のパソコン上で動作する大規模言語モデルです。
ChatGPTやGeminiのようなクラウドAIとは異なり、インターネット接続なしでも動作します。
主なメリット
- 機密情報を外部に送信しない
- 月額費用が不要
- オフラインでも利用可能
2026年現在ではLM StudioやOllamaなどが代表的な実行環境です。
ローカルLLMをさらに勉強したい方へ
LM Studioを使うだけでなく、Pythonを使ってローカルLLMの仕組みやモデルの扱い方まで学んでみたい方は、次の書籍もおすすめです。
実際にコードを書きながら進められるので、しっかり理解できます。
 | 価格:3960円 |

LM Studio Bionicとは
LM Studio の開発元である Element Labs が提供している オープンモデル向けのAIエージェントアプリ です。
従来のチャットではなく、ファイル操作、文書作成、コーディング、調査などといった作業をエージェントとして実行できることが最大の特徴です。
無償で使用できる?
Bionic Pricing | LM Studioに記載の通り、ローカルLLM実行、音声認識、LM Linkなどは無料プランで利用できます。
ただし、LM Studio Secure Cloud のモデル利用は従量課金となっています。
今回試した環境
今回は以下の通り、一般的なノートPCで試しました。
<PCのスペック>
- CPU:Core i7
- メモリ:16GB
- GPU:Intel UHD Graphic 620
- OS:Windows11 Pro
<LM Studio Bionicやモデル>
- ローカルLLM環境:Bionic 1.1.1+5
- モデル:Gemma 4 E4B
LM Studio Bionicをインストール
- LM Studioのサイトへアクセスしてダウンロード
URL:https://lmstudio.ai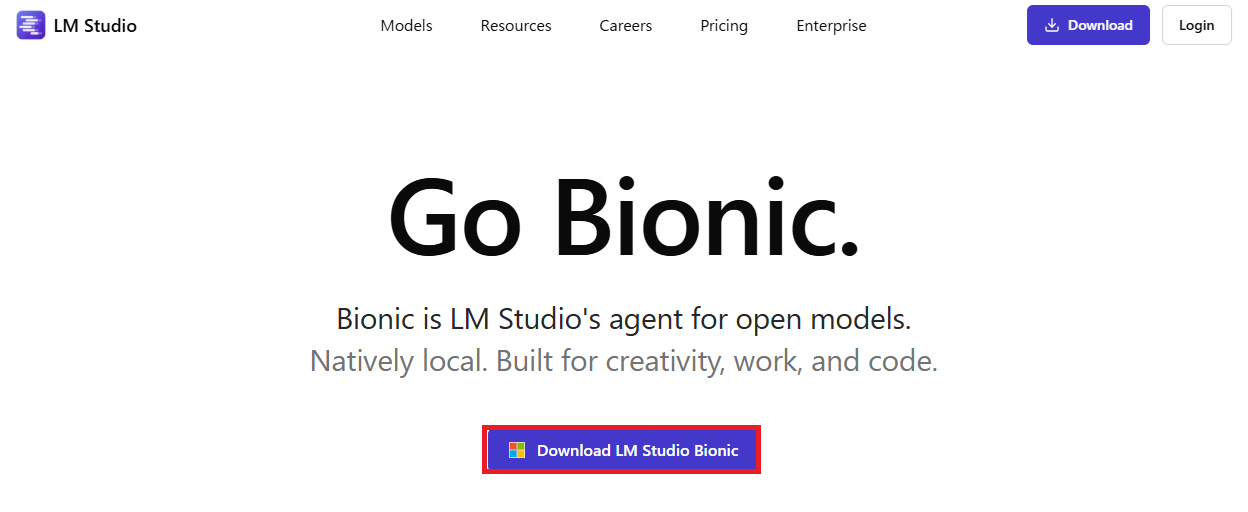
- ダウンロードしたインストーラを実行
※インストーラのファイル名はバージョンにより異なります - 「同意する」をクリック
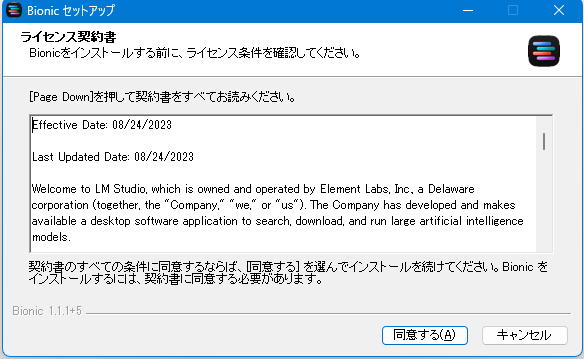
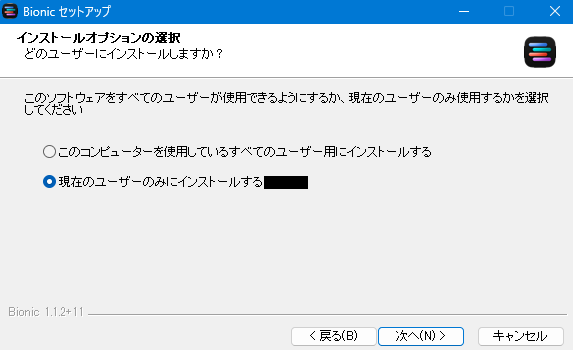
- LLM Studioを利用するユーザを全ユーザにするか、現在ログインしているユーザのみにするか選んで「次へ」をクリック
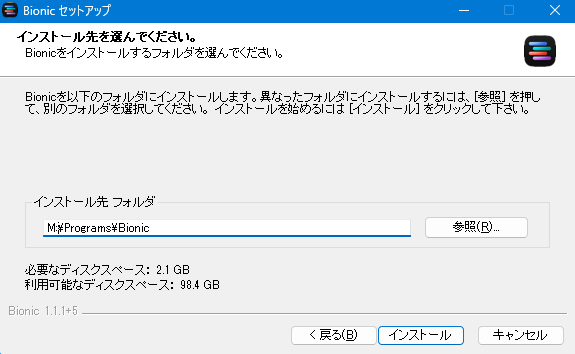
- インストール先を選んで「インストール」をクリック
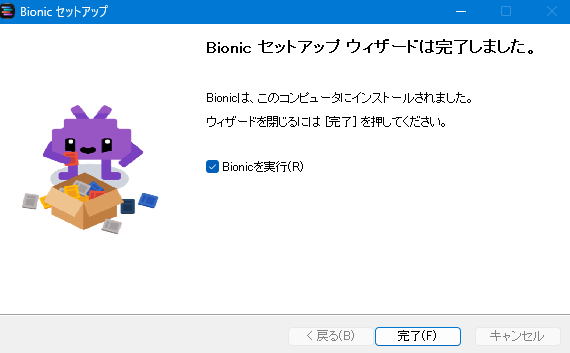
- 「完了」をクリック
インストールを完了しただけででは、まだ利用できません。(下の絵のようにボタンが押せない)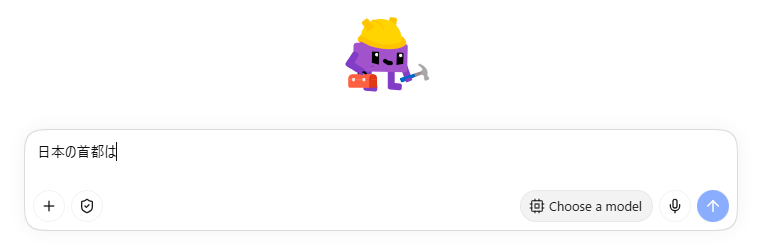
この後で説明するモデルのダウウンロードが必要です。
モデルのダウンロード
使用するモデルをダウンロードする必要があります。
モデルはBionicの設定画面でダウンロードできます。
ローカルLLMにはさまざまなモデルがあり、モデルによって得意な作業や必要なパソコン性能が異なります。
一般的には、大きなモデルほど複雑な指示や判断を得意とする傾向がありますが、その分、多くのメモリや処理能力が必要になります。
「モデル」について知りたい場合は「LLMの「モデル」とは?」のページを参照ください。
おすすめモデル
あまりスペックが高くない一般PCの場合は、モデル規模が4B~8Bくらいのモデルが良いです。
- 低スペック(GPUなし・メモリ16GB以下など)の場合
Gemma 4 E4B
Qwen 3 4B - 通常スペック(GPUあり)
Gemma 3 12B - コーディング用途
Qwen Coder
モデルのダウンロード手順
- 画面左上のアイコンをクリック
- 左下の「Settings」をクリック
- 左側のメニューから「Explore」を選択して使用するモデルを選択後に「Download」をクリック
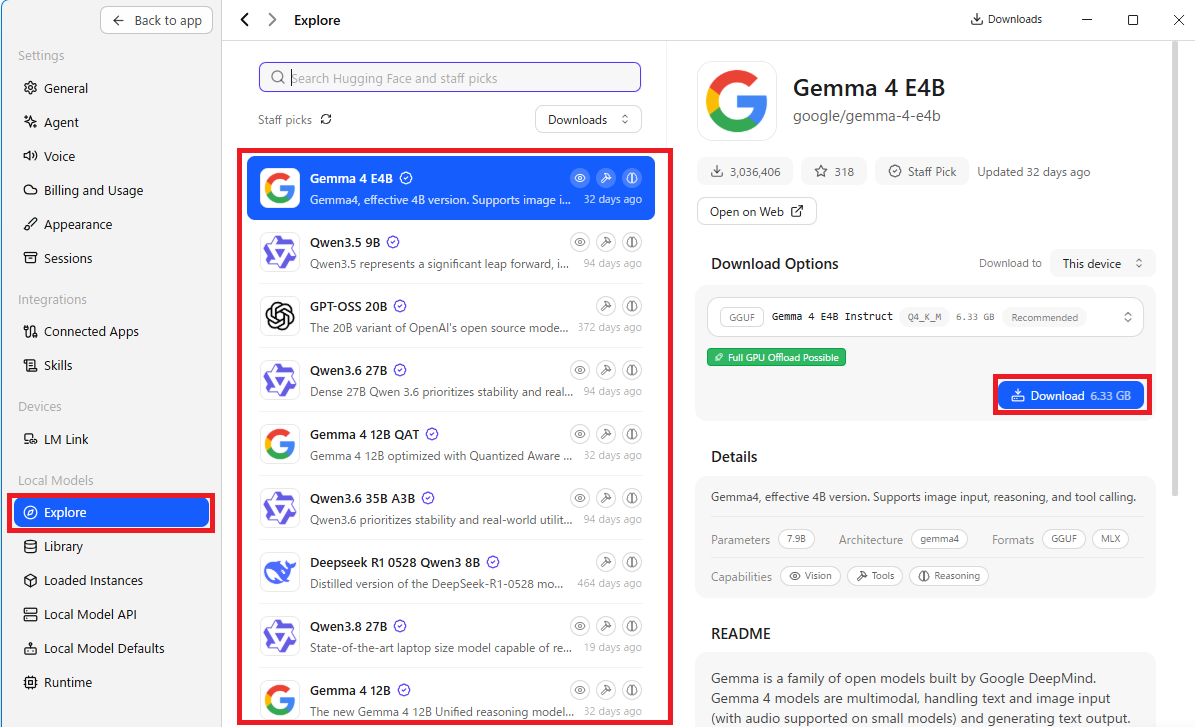
(今回はGemma 4 E4Bを選択しました。)
LM Studio Bionic 速度改善の設定
AutoFit context lengthの調整
低スペックのPCだと応答速度に時間がかかることがあります。
今回の環境の場合、以下のような簡単な質問でも12分かかりました。
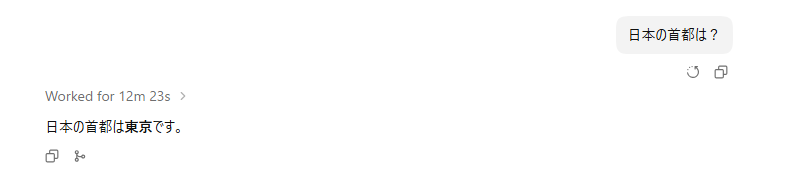
対処として「AutoFit context length」の設定を変えます。
「AutoFit context length」はSettins画面の「LocalModel Defaults」で指定が可能です。
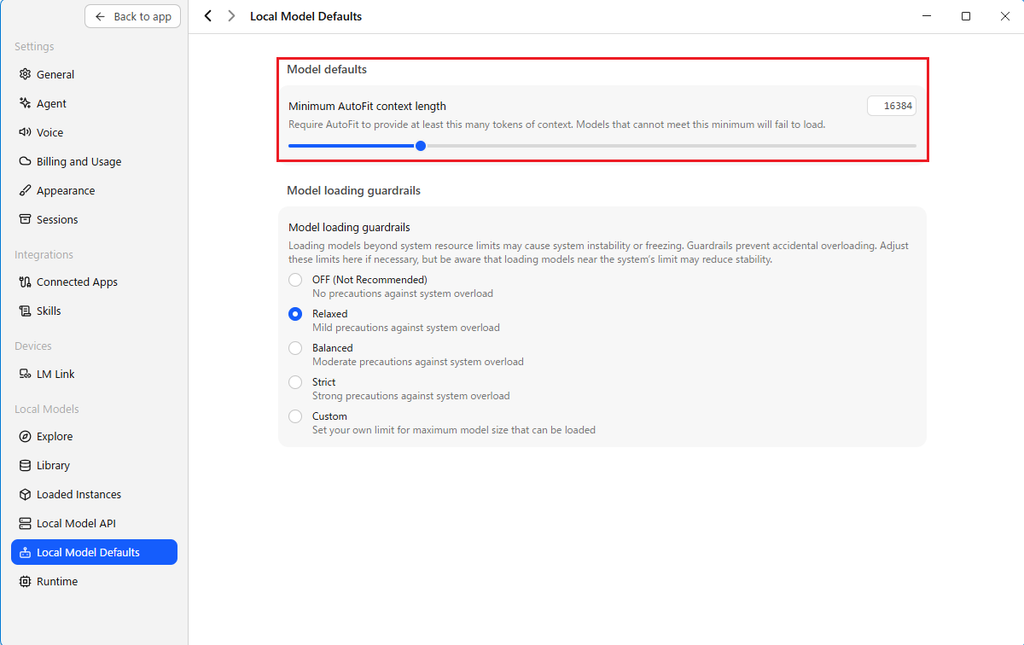
LLMには「コンテキストウィンドウ」という仕組みがあり、過去の会話、読み込んだ文書などを保持するための領域があります。
この数値を下げることでメモリ消費量を抑えることができ、スワップも発生しにくくなるので、応答速度も改善します。
しかし、長い会話を忘れやすくなる、巨大なPDFの処理が苦手になるなどのデメリットもあります。
今回使用したPC(Core i7 メモリ16GB)の場合、4096~8192くらいが最適な設定値です。
新しいチャットで会話する
LLM Studio Bionicに限ったことではないですが、ずっと同じチャットで会話していると、会話のコンテキストが大きくなり、パフォーマンスが落ちます。
新しいチャットで会話を再開させたい場合、「ここまでの作業内容、決定事項、重要な設定、現在の問題点を、新しいセッションに引き継げるように簡潔にまとめてください」などとお願いし、新しいチャットでは「前のセッションからの引き継ぎ情報です。これを前提に作業を続けてください。」とすれば良いのです。
画面表示の日本語化について
LM Studio Bionic バージョン1.1.3から日本語に対応しました。
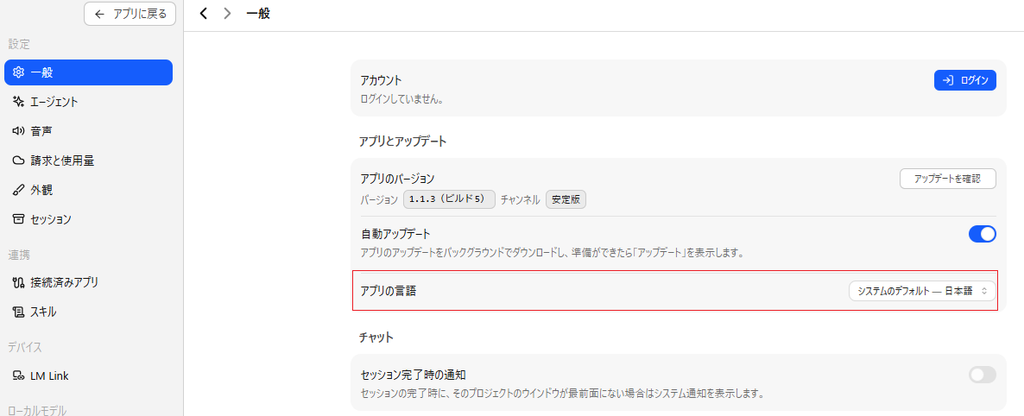
バージョン1.1.3は2026年9月16日に公開されています。古いバージョンを使用していて日本語表示したい場合は新バージョンを利用ください。
LLM Studio Bionicを試してみる
今回は簡単なヒアリングメモをもとに、要件定義書の作成をお願いしてみました。
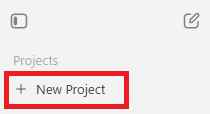
- 左にある「New project」をクリック
- 名前と作業用フォルダ(Working directory)を指定
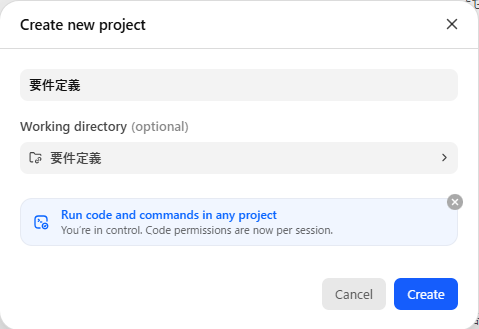
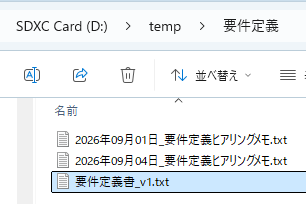
- 詳細は省略しますが、要件定義出のヒアリングメモのテキストファイルを作業用フォルダ(Working directory)に置いて、これをもとに要件定義書を作成してと尾根愛すると、要件定義書を作成してくれました。
FAQ
- おすすめのモデルは何ですか?
文書作成・対話:Qwenシリーズ
コーディング:Qwen Coder
推論・思考重視:DeepSeek系
軽量動作:Gemmaシリーズ - 応答速度が非常に遅い場合はどうすればよいですか?
メモリ16GB以下の環境では、コンテキスト長が大きすぎると動作が極端に遅くなることがあります。
「Settings → Local Model Defaults → Minimum AutoFit context length」で、4096~8192へ変更すると改善することがあります。 - LM StudioとLM Studio Bionicの違いは何ですか?
LM StudioはローカルLLMを実行するための環境です。一方でLM Studio Bionicは、LLMを利用してファイル操作や文書作成などを行うAIエージェントです。 - モデル規模が小さいとどのようなメリットがありますか?
動作が高速で使用メモリが少ないなど、低スペックPCでも快適に動作できます。 - モデル規模が小さいとどのようなデメリットがありますか?
「日本の首都は?」のような単純な質問であれば小規模モデルでも回答できますが、「この仕様書を分析して改善案を提案してください」などの複雑な推論が苦手となります。 - チャットで指示すると「Engine protocol runtime llama-server for xxxxxx exited before becoming healthy. exitCode=3221226505, signal=null」のようなエラーになる。
ローカルLLMが起動できなかった可能性があります。
GPU offloadを無効化したり値を小さくすることで解決するかもしれません。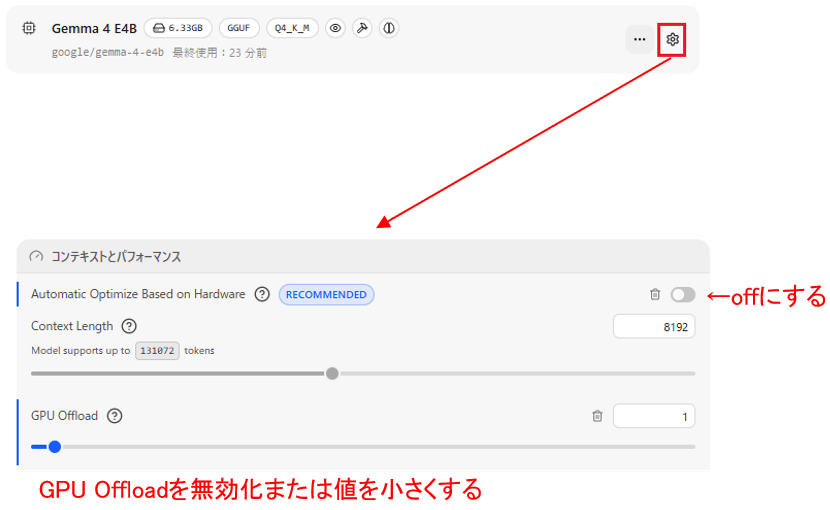
また、context length値を小さくすることも解決につながる可能性がります。
コメント